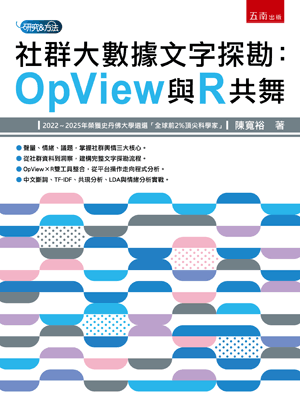
社群大數據文字探勘:OpView與R共舞
作  者╱
陳寬裕
出版社別╱
五南
書  系╱
研究&方法
出版日期╱
2026/11/10   (1版 1刷)
  
即日起五南舊官網僅提供書籍查詢,如欲購書,請至五南新官網 https://www.wunan.com.tw/
I  S  B  N ╱
978-626-442-976-4
書  號╱
1H5B
頁  數╱
324
開  數╱
16K
定  價╱
480
教學資源╱
,題庫(隨書附送),教學影片(隨書附送)


☉聲量、情緒、議題,掌握社群輿情三大核心。
☉從社群資料到洞察,建構完整文字探勘流程。
☉OpView × R雙工具整合,從平台操作走向程式分析。
☉中文斷詞、TF-IDF、共現分析、LDA與情緒分析實戰。

社群媒體每天產生龐大的文字與互動資料,這些看似零散的聲音,其實蘊藏著市場趨勢、消費者態度與社會議題。如何從龐雜資訊中找出關鍵訊號,轉化為有意義的洞察,正是社群大數據分析的核心。
本書以「OpView × R」為核心,建構從平台分析到程式實作的完整學習路徑。從聲量、情緒與議題三大核心出發,帶領讀者掌握社群輿情分析方法;再進一步運用 R 進行資料處理、中文斷詞、DTM建構、TF-IDF、共現分析、LDA主題模型與情緒分析,逐步建立社群大數據文字探勘的實戰能力。
這不只是一本教你「如何操作」的工具書,更是一本帶你學會「如何分析」與「如何解讀」的實戰指南。從平台上的數據,到程式中的文字;從看見聲量,到理解議題與情緒,最終將龐雜的社群資料轉化為可理解、可解讀、可應用的策略洞察。

陳寬裕

現職:
屏東科技大學休閒運動健康系特聘教授

榮譽:
2022∼2025年榮獲史丹佛大學遴選「全球前2%頂尖科學家」

學歷:
嘉義大學觀光休閒研究所博士班
長榮大學經營管理研究所博士
清華大學工業工程研究所碩士
臺灣大學大氣科學系學士

Email:
pf.kuan.yu.chen@gmail.com

第1章 什麼是社群大數據分析
1-1 社群大數據分析的定義與範圍
1-2 社群大數據分析在做什麼
1-3 社群大數據分析的限制與迷思
1-4 社群資料的本質與分析邏輯
第2章 社群資料的核心分析指標
2-1 為什麼要細分聲量、情緒與議題
2-2 聲量
2-3 情緒
2-4 議題
2-5 聲量、情緒與議題的交互關係
第3章 社群大數據的分析方法與工具
3-1 社群資料蒐集與前置處理
3-2 聲量分析方法
3-3 情緒分析方法
3-4 議題分析方法
3-5 社群分析工具與實務應用
第4章 OpView與社群口碑核心指標
4-1 OpView輿情觀測平台簡介
4-2 OpView的功能模組架構
4-3 OpView的八大社群口碑數據指標
4-4 OpView實務操作流程:從資料到洞察的一次完整分析
第5章 在OpView中進行主題設定
5-1 輿情分析流程
5-2 登入OpView
5-3 主題設定的必要性與重要性
5-4 主題關鍵字
5-5 主題關鍵字的製作
第6章 OpView八大輿情分析指標解析
6-1 觀測期間與資料來源的設定
6-2 聲量指標
6-3 頻道數擴散指標
6-4 回應比指標
6-5 情緒比指標
6-6 作者指標
6-7 關鍵字指標
6-8 競爭風暴圖
6-9 OpView應用指引
第7章 平台輿情分析的限制與延伸
7-1 平台化輿情分析的角色與能力邊界
7-2 輿情分析層級的轉換:從描述到分析與推論
7-3 平台分析的結構性限制
7-4 當平台分析遇到瓶頸:R語言的補足角色
7-5 從OpView到R:資料匯出與結構轉換的分析思維
7-6 本章小結:平台與R的角色分工
第8章 R與RStudio入門
8-1 RStudio是什麼
8-2 RStudio的介面構成與基本操作方式
8-3 為什麼要學R語言?
8-4 R的基本運作邏輯:指令、執行與結果
8-5 物件與指派:在R中保存計算結果
8-6 注解與良好撰寫習慣
第9章 資料型態與資料結構
9-1 基本資料型態
9-2 數值型資料
9-3 字元型資料
9-4 因子型資料
9-5 邏輯型資料
9-6 向量
9-7 資料框(Data Frame)
第10章 資料的讀入與初步清理
10-1 範例資料介紹
10-2 設定R的工作環境
10-3 讀入資料
10-4 安裝與載入套件dplyr
10-5 「%>%」管線運算子
10-6 排序與選取資料
10-7 篩選與抽樣資料
10-8 刪除重複值、遺漏值與過短文本
10-9 資料型態轉換
10-10 統計與彙整資料
10-11 資料儲存
10-12 資料清理在後續分析中的角色
第11章 資料的進階清理與視覺化
11-1 新增變數(欄位)
11-2 使用stringr套件清理文字資料
11-3 數值資料視覺化檢查(使用ggplot2)
第12章 R的流程控制
12-1 for迴圈:逐筆處理資料
12-2 if條件判斷與stop()
12-3 try()與tryCatch():安全處理錯誤
第13章 函數的製作
13-1 函數的基本結構:輸入、運算與輸出
13-2 簡單的函數範例:計算平方
13-3 參數設計與預設值:讓函數更好用
13-4 函數的輸出型態
13-5 在函數中進行錯誤檢查
13-6 函數命名、注解與可讀性
13-7 函數在分析流程中的角色
第14章 斷詞與詞頻分析
14-1 斷詞
14-2 使用JiebaR進行中文斷詞
14-3 從斷詞結果到可分析資料
14-4 詞頻分析
14-5 如何解讀詞頻結果
第15章 文字資料的矩陣化
15-1 文字資料的結構化與矩陣表示概觀
15-2 DTM的基本概念
15-3 DTM也會遺失語意
15-4 控制詞項數量的必要性
15-5 DTM的建立方法
15-6 TF-IDF權重的概念與意義
15-7 TF-IDF矩陣的計算與應用
15-8 共現性分析與詞項關聯結構
第16章 LDA主題模型
16-1 LDA的基本概念
16-2 建立LDA模型
16-3 模型評估與選擇最佳主題數
16-4 網格搜尋法實作與分析
第17章 情緒分析
17-1 情緒分析的概念與功能
17-2 中文情緒分析方法概述
17-3 使用OpView的情緒分析結果
17-4 情緒分析的角色與誤解
第18章 主題建模完整流程示範
18-1 取得原始語料庫
18-2 中文斷詞處理
18-3 建立DTM
18-4 LDA網格搜尋與最佳主題數
18-5 輸出LDA主題建模檔與主題雲

人工智慧:從技
術演化到全產業
智慧升級
不用數字的研究
:質性研究的思
辯脈絡
無人機的基礎概
論:Pytho
n程式設計實作
Case Cl
osed! H
ow to g
et your
resear
ch publ
ished
量化研究與統計
分析:SPSS
與R資料分析範
例解析
固定收益證券與
利率衍生性商品
:使用Pyth
on語言(附光
碟)


,題庫(隨書附送),教學影片(隨書附送)

若要索取未隨書附送(外加)且未於此提供下載的教學資源,請詳洽業務人員(02-27055066#824)(僅提供教師使用)


Chapter1 什麼是社群大數據分析
  在現今的數位社會中,社群媒體已深度融入人們的日常生活。無論是分享生活、表達意見,或對品牌與事件發表看法,人們都會在各種平台上留下大量文字、圖片與互動紀錄,例如:留言、按讚、轉貼與評論。隨著這些資料不斷累積,社群平台逐漸形成龐大且即時更新的資料來源。因此,透過系統化的方法分析這些資料,便形成了所謂的「社群大數據分析」(social media big data analytics)。這種分析方式能協助研究者與企業了解消費者的想法、掌握品牌形象的變化,以及觀察社會輿論的發展趨勢,因而成為當代市場研究與輿情分析的重要工具。
  然而,社群大數據分析的重點並不只是簡單統計留言數、按讚數或分享數。如果只停留在數字的累積,而沒有思考資料背後所代表的意義,就很難真正理解使用者的想法與態度。例如:留言數增加未必代表好評增加,可能反而是負面討論升高;按讚數高,也未必代表使用者真正認同內容。因此,進行社群資料分析時,必須先釐清資料的來源、內容與研究目的,並搭配適當的分析方法,才能從龐雜的資料中提取有價值的洞察。
  基於此,本章將先從概念層面出發,說明什麼是「社群大數據分析」,並進一步介紹其主要分析範圍、核心精神,以及實務上常見的幾種誤解。透過建立清楚的基本概念,讀者將能更容易理解後續章節所介紹的分析方法與實際應用,並在進行社群資料分析時,避免落入只看數字而忽略意義的常見陷阱。
1-1 社群大數據分析的定義與範圍
  在正式討論「社群大數據分析」之前,首先必須釐清幾個基本概念,包括:什麼是「社群」、什麼是「大數據」,以及進行社群資料分析時應掌握的核心思維。若未先理解這些概念,後續在分析社群資料時,往往只停留在聲量、情緒或熱門議題等指標的統計,容易流於數字的堆疊,而難以真正理解資料背後所反映的輿情意涵。因此,本節將先說明社群大數據分析的基本定義與分析範圍,作為後續章節討論分析方法與實務應用的重要基礎。
一、什麼是「社群」
  在本書中,「社群」(social media)指的是一種讓人們可以在網路上發表意見、分享內容,並且彼此看得到,也能互相回應的數位平台或交流空間。換句話說,只要一個平台能讓使用者公開表達想法,並讓其他人看到、回應或參與討論,就可以被視為社群的一種形式。這類平台不一定侷限於大家熟悉的社群網站,例如:Facebook、Instagram、Threads或X。只要使用者能夠發文、留言、分享或回覆他人的內容,形成公開可見的互動關係,就具有社群的特性。
  例如:在 Facebook 發表貼文、在 Dcard上參與討論、在 YouTube影片下方留言,甚至是在新聞網站的留言區分享個人看法,這些行為都屬於社群互動的範疇。由此可見,判斷一個平台是否屬於社群,關鍵並不在於它的名稱或類型,而在於使用者之間是否能夠看見彼此的意見,並透過留言、分享或回應形成持續的交流與互動。
  更重要的是,在社群環境中,意見與情緒通常不是由單一個人獨立形成,而是在多人互動的過程中逐漸被塑造與放大。例如:一則原本普通的貼文,可能因為大量按讚數而迅速受到關注,也可能因為留言討論不斷增加,而使討論焦點逐漸改變,甚至引發更大的議題關注。因此,社群並不是單純把許多人的想法加總在一起,而是一個讓意見、情緒與觀點透過持續互動,而不斷擴散、累積並放大的公共討論空間。
二、什麼是「大數據」
  「大數據」(big data)這個詞,常讓人直覺聯想到「資料很多」。然而,在社群分析的情境中,「大」並不只是單純指資料量龐大,更重要的是資料的產生方式、資料本身的特性,以及分析時所面臨的複雜性。換句話說,大數據不只是「很多資料」,而是指一種規模龐大、形式多樣,且難以用傳統方法直接整理與理解的資料型態。
  在本書所討論的社群情境中,「大數據」主要可以從三個面向來理解。
1. 資料量與持續性
社群平台上的資料會隨著時間不斷累積,而且幾乎是即時且持續地產生。每天都有大量使用者發文、留言、分享與回應,使得相關資料以長時間、連續的方式快速增加。這種持續生成的特性,使研究者能夠觀察某個議題在不同時間點的討論變化,例如:某個事件如何突然引發大量討論,或某個品牌議題如何在一段時間後逐漸降溫。
2. 資料形式的非結構化特性
與傳統問卷或統計資料不同,多數社群資料並不是整齊排列的數字或表格,而是以文字內容為主。這些文字中常夾雜表情符號、口語語氣、網路用語,甚至隱喻與諷刺。例如:一句看似簡單的留言,可能同時包含情緒、態度與幽默語氣,使得資料難以直接套用傳統量化分析方法。因此,在進行社群大數據分析時,往往需要先整理與解讀這些非結構化資料。
3. 資料脈絡的複雜性
社群資料的另一個重要特徵,是內容往往與特定情境密切相關。一則留言若單獨閱讀,可能很難理解其真正意義,必須同時考慮發文時間、所在平台、與其他使用者的互動關係,以及當時發生的社會事件或新聞背景,才能正確解讀其意涵。換言之,社群資料不只是單一訊息,而是嵌入在一個複雜的討論脈絡之中。
  因此,本書所指的「大數據」,並不是強調需要多麼高深的程式技術或運算能力,而是強調研究者在面對大量、持續產生且高度情境化的社群資料時,必須採取一種有系統的分析思考方式,才能從龐雜的資料之中整理出具有意義的資訊與洞察。
三、社群大數據分析的核心精神
  在理解了「社群」與「大數據」之後,下一個重要的問題是:社群大數據分析究竟想達成什麼目的?換句話說,我們在分析這些大量的社群資料時,真正關心的是什麼。整體而言,社群大數據分析並不是單純整理資料或計算數字,而是一種試圖理解線上討論現象的分析方法。本書將其核心精神歸納為以下三個重點:
1. 觀察行為痕跡,而不是直接讀心思
社群平台上的資料,其實是使用者在網路上留下的各種「行為痕跡」。例如:發表貼文、回覆留言、按讚、分享內容或轉貼文章等。這些行為都會被記錄並形成可觀察的資料。因此,社群大數據分析的重點,是觀察人們在網路上「做了什麼」、「什麼時候做」,以及「與誰互動」。然而,這些資料並不能直接告訴我們每個人內心真正的想法。例如:一個人按讚某則貼文,可能是認同內容,也可能只是表示看過。因此,社群分析的基本原則是:從可觀察的行為出發,而不是試圖直接推測每個人的內心想法。
2. 從單一指標走向多層次理解
在社群分析中,單一指標往往難以完整描述討論的狀況。例如:只看「聲量」的高低,並不能說明討論是正面還是負面,也無法了解人們究竟在討論什麼。因此,社群大數據分析通常會同時結合多種分析面向,例如:聲量、情緒、議題內容,以及互動關係等。舉例來說,一則貼文可能擁有很高的聲量,但留言內容可能同時包含支持、批評或諷刺等不同情緒;討論議題也可能分成數個方向;而互動網絡則能顯示哪些帳號在討論中,扮演較大的影響角色。因此,分析的目的並不是只看「數字多不多」,而是透過不同指標的結合,理解整體討論的結構與脈絡。
3. 承認限制,強調理解而非預測
最後,社群大數據分析也必須承認資料本身的限制。社群平台上的使用者並不能完全代表整體社會,因此社群資料無法直接當作所有人的意見。此外,即使觀察到某些討論趨勢,也不一定能精確預測未來的行為或結果。因此,社群大數據分析最重要的價值,在於幫助研究者理解當下的討論現象,例如:哪些議題正在被關注、人們的意見與情緒如何互動,以及討論如何在網路上擴散。換句話說,社群大數據分析是一種協助理解網路輿情與討論動態的工具,而不是一個能自動給出結論或預測結果的機器。